Google presenta las nuevas TPU 8tx y 8i Max: seguridad en el 'hardware' y contexto masivo para los agentes de IA
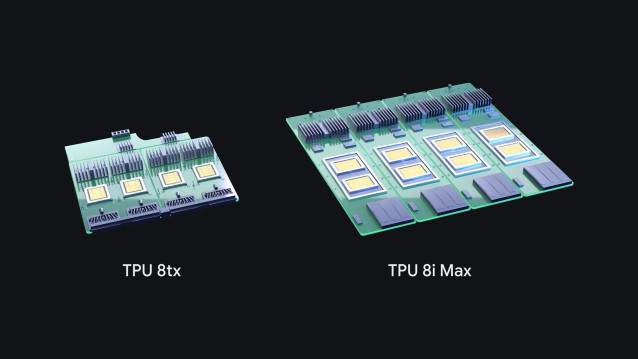
Google ha presentado dos nuevas TPU de octava generación TPU 8xt y TPU 8i Max, pensadas para la inferencia segura y confidencial con protección de datos en la capa de 'hardware' en el primer caso, y para duplicar cómputo, SRAM y ancho de banda HBM, de cara a manejar ventanas de contexto masivas, en el segundo caso.
Estas nuevas TPU se añaden a la familia de la octava generación, compuesta por los modelos TPU 8t (dirigido a acelerar el entrenamiento a gran escala) y 8i (para impulsar la inferencia con menor coste y latencia) presentadas en abril de este año, en el marco del Google Cloud Next'26, de cara a mejorar su infraestructura de "hipercomputación de IA", es decir la que permite ejecutar y escalar cargas de trabajo más demandantes de inteligencia artificial (IA).
Ahora, Google ha dado un paso más allá y ha presentado la TPU 8i Max para "ventanas de contexto masivas y la mayor densidad de cómputo por rack", y la TPU 8tx, para inferencia "segura y confidencial", completando su gama de TPU con cuatro sistemas lanzados por primera vez en un año, como ha compartido en un comunicado.
"A medida que la computación pasa de la escala humana a la de los agentes, las empresas solicitan aceleradores capaces de razonar en las enormes ventanas de contexto de los modelos de IA. Además, algunos clientes sujetos a estrictas regulaciones solicitan capacidades de cifrado especializadas para cargas de trabajo únicas", ha compartido el vicepresidente senior y director de tecnología e IA e infraestructura de Google, Amin Vahdat.
Concretamente, la TPU 8tx está pensada para empresas reguladas o gobiernos que ejecuten modelos propios o de frontera y utilicen agentes autónomos, de cara a proteger sus datos más sensibles. Esto se debe a que integra la seguridad en la capa de 'hardware'.
Es decir, según ha explicado, los datos y los pesos del modelo permanecen protegidos y aislados, incluso mientras se procesan, en lugar de solo cifrarse en almacenamiento o en tránsito.
Asimismo, utilizan el mismo silicio que la TPU 8t y se combina con servidores con CPU AMD EPYC de 5º generación. Google también ha especificado que ofrece hasta 2 veces menos de latencia que la TPU 8t, al adoptar la red Boardfly para razonamiento en tiempo real.
Esta TPU 8tx también permite a los equipos ajustar modelos con datos privados, destilar modelos grandes en otros más pequeños y entrenar agentes con aprendizaje por refuerzo, todo ello, "sin mover datos sensibles entre clústeres separados".
Por su parte, el sistema TPU 8i Max, combina dos chips TPU en un solo paquete para atacar el problema de la limitación de la memoria. Esto ocurre cuando, por ejemplo, docenas de agentes de IA trabajan de forma conjunta en todo un código fuente de 'software' o procesando horas de vídeo, acabando con el ancho de banda y convirtiéndolo en un cuello de botella.
En este sentido, la TPU consigue ofrecer el doble de cómputo, de SRAM y de ancho de banda HBM que la TPU 8i, como ha indicado Google, dado que cabe el doble de silicio en el mismo espacio de rack. Como resultado, los centros de datos pueden desplegar más potencia por metro cuadrado y por vatio.
Con todo, sirven para entrenamiento escalable, para razonamiento de baja latencia, para computación confidencial y para ventanas de contexto masivas y la mayor densidad de cómputo por rack.
ACCESIBILIDAD PARA DESARROLLADORES
Google también ha puesto sobre la mesa cómo ha estado trabajando sistemáticamente para eliminar barreras de adopción de esta tecnología para desarrolladores. Concretamente para que, "las TPU sean tan fáciles de usar como el 'hardware' de propósito general".
En este marco, ha anunciado novedades como la apertura del desarrollo de TPU a todos los desarrolladores de PyTorch. Esto permite ejecutar código PyTorch y modelos de Hugging Face de forma nativa en la TPU, sin reescribir código, con soporte para vLLM y SGLang.
Para que la optimización del 'hardware' sea sencilla, su nuevo modelo de agentes de TPU de código abierto se ha integrado directamente con herramientas de codificación como Claude Code, Cursor o Google Antigravity, para identificar cuellos de botella y automatizar los ajustes de kernels personalizados.
Con todo ello, Google ha asegurado que la pila nativa de 'software' vLLM-TorchTPU logró marcas de precio-rendimiento "de vanguardia" en las pruebas InferenceX y AgentX, que evalúan la codificación agente realista y e trabajo con contextos extensos.
Por otra parte, la compañía también ha compartido otros detalles como Agent Compute Engine, un sistema que suspende sesiones de agentes inactivas y mueve su memoria de trabajo fuera del chip en milisegundos, reduciendo costes.
Finalmente, con Cloud Pathways, ya disponible de forma general en Google Kubernetes Engine (GKE), la compañía lleva a todos los clientes de Google Cloud el entorno de ejecución de Google DeepMind respaldando a Gemini.

